Tarjima dasturlari yoki çatbotlar özbek tilida ham xatosiz işlaşi uçun nima qiliş kerak, buning uçun qanday yondaşuvlar talab etiladi? Germaniyaning Kayzerslautern-Landau universiteti magistranti Latofat Bobojonova ayni şu kabi savollarga javob topiş uçun ilmiy izlaniş olib bormoqda. Kun.uz muxbiri bilan suhbatda u kompyuterning matn yoki nutq orqali özbek tilini yaxşiroq tuşunib, qoniqarli javob qaytarişi uçun nimalar yetişmayotgani, Google’dagi muammolarga taklif etgan yeçimlari haqida gapirib berdi.
Latofat Bobojonova Toşkent şahridagi 266-maktabda ta’lim olgan. Oliy ta’limning bakalavriat bosqiçini Toşkent axborot texnologiyalari universitetida dasturiy muhandislik yönalişi böyiça tamomlagan. Şundan söng DAAD xalqaro stipendiyasini yutib, Germaniyaning Kayzerslautern-Landau universitetiga öqişga kirgan va sönggi bir yarim yilda mazkur dargohda ilmiy xodim sifatida faoliyat yuritgan.
U yerda “Kam resursli agglutinativ tillar uçun transformer modellarda morfologik ma’lumotli tokenizatorlar ta’sirini örganiş” mavzusida ilmiy iş olib borgan. Yoş olima kam tarqalgan va murakkab tuzilmali tillarda sun’iy idrok yaxşi işlaşi uçun sözlarni grammatik jihatdan töğri ajratiş qançalik muhimligini örgangan. Xususan, özbek tilida tabiiy tilni qayta işlaş (NLP) funksiyasini takomillaştirişni tadqiq qilgan.
“BERT, GPT, LLaMA, T5 kabi katta til modellarining özbek tilida işlaşini yaxşilaş borasida izlandim. Tadqiqotlar şuni körsatdiki, agar bu modellarni özbek tilidagi matnga sözlar yoki oddiy harflar ketma-ketligi asosida emas, balki morfemalarga ajratgan holda örgatsak, ularning özlaştiriş tezligi 8 barobar oşadi. Bu nimani anglatadi? Masalan, oddiy holatda modelni tört kunda trenirovka qiliş kerak bölsa, morfemalarga asoslangan yondaşuv bilan uşbu jarayon atigi yarim kunda yakunlanadi. Natijada siz nafaqat vaqt, balki mablağ va elektr energiyasini ham tejaysiz. Demak, bu ekologik jihatdan ham foydalidir. Eng muhimi, qisqa vaqt içida savollarga aniq javob beradigan modelga erişiş mumkin böladi”, – deydi u.
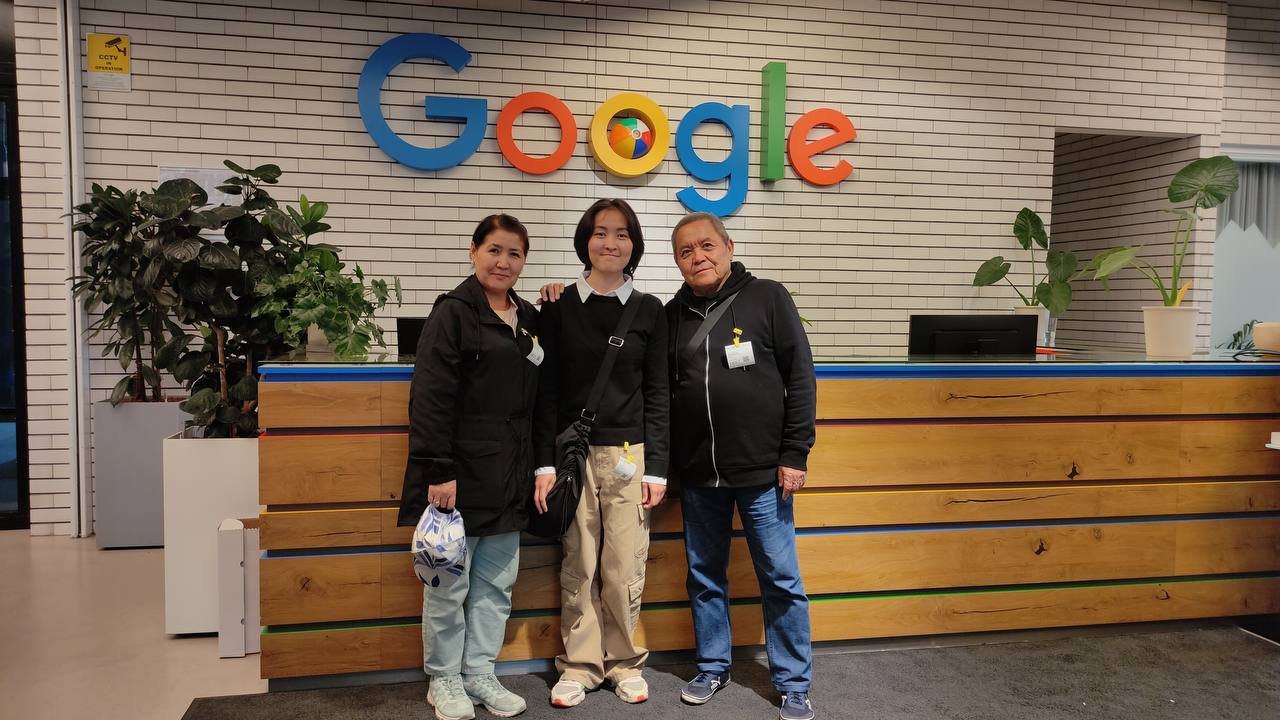
Latofatning aytişiça, özbekça matnlarini raqamli qayta işlaş jarayonida aqlli tizimlarning til birliklarini aniqlay olişi qobiliyati muhim ahamiyatga ega. Çunki özbek tilida bir söz butun bir jumla funksiyasini bajarişi ham mumkin.
“Masalan, “kelmaganlardanmisiz” degan söz qanday söz turkumiga kiradi? Bu birlik yuklamami, fe’lmi yoki butun bir gap vazifasini bajarayotgan murakkab birikmami? Tadqiqot loyihamda aynan şu kabi savollarga javob izladim. Berilgan gapdagi har bir sözning ot, fe’l, sifat singari qaysi söz turkumiga mansubligini neyron tarmoqlar yordamida belgilaş funksiyasini takomillaştiriş takliflarini işlab çiqdim. Bunday tizimni yaratiş uçun avvalo özbek tilining lingvistik xususiyatlarini çuqur örgandim. Tahlil qilişda asosiy birlik nima bölişi kerak — sözmi, morfemami yoki qöşimçami? Şularni tekşirdim va sun’iy idrok modellari uçun kerakli formatda ma’lumot tayyorlaş usullarini yozdim. Özbek tilining murakkabligi, ya’ni qöşimçalar orqali grammatik ma’no ifodalaş tizimi (agglutinativ tuzilişi) jarayonni biroz qiyinlaştirdi. Ingliz tilida bu kabi murakkablik kamroq uçraydi”,